

Воспроизводимый выпуск
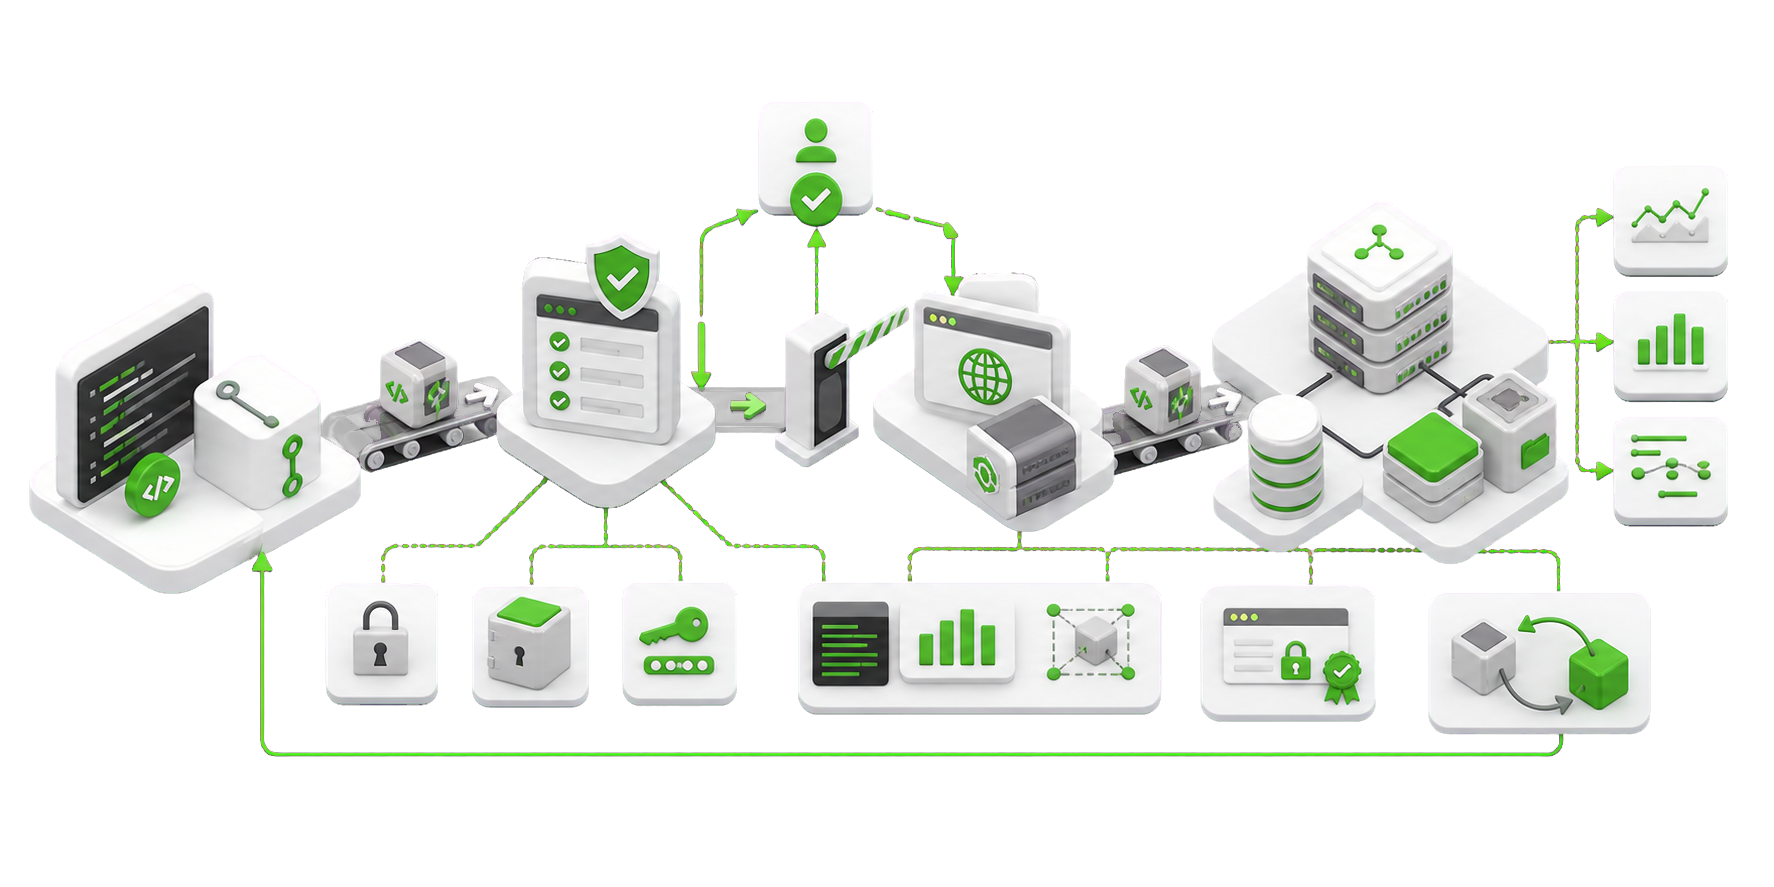
Версия проходит известный путь от репозитория и проверок до нужного окружения, а результат выпуска фиксируется и проверяется.
Выпуск, наблюдаемость и восстановление
Проектируем и настраиваем инфраструктуру для сайтов и веб-приложений. Автоматизируем сборку и выпуск, разделяем окружения, организуем мониторинг, журналы, резервное копирование и восстановление с учётом требований проекта.
Что за услуга?
DevOps помогает выпускать изменения предсказуемо и поддерживать инфраструктуру в контролируемом состоянии. S.O.L CORP настраивает окружения, автоматическую сборку и развёртывание, мониторинг, резервное копирование и управление конфигурациями. Решения документируются, а доступы и зоны ответственности согласуются с командой заказчика.
Практическая ценность
Версия проходит известный путь от репозитория и проверок до нужного окружения, а результат выпуска фиксируется и проверяется.

Разделяем пользовательские и сервисные учётные данные, выдаём минимально необходимые права и убираем чувствительные значения из кода.

Логи, метрики, трассировки и health checks связываются с версией и пользовательским влиянием, чтобы диагностика не строилась на догадках.

Определяем состав резервной копии, хранение и доступ, а затем подтверждаем процедуру отдельным восстановлением и документируем результат.
Когда нужен DevOps-контур

Шаги живут в памяти одного специалиста, отличаются между окружениями и создают риск пропущенной миграции или неверной конфигурации.
Нет связанных журналов, сигналов по критичным сценариям и понятной точки, с которой начинается диагностика инцидента.

Нужно согласовать версии, конфигурацию, данные, зависимости, порядок запуска и совместимость между приложениями.
Личные учётные данные используются в автоматизации, права не пересматриваются, а смена специалиста угрожает непрерывности работы.
Архивы создаются, но неизвестно, содержат ли они все данные и можно ли восстановить согласованное состояние приложения.
Эксплуатационный контур
DevOps и настройка инфраструктуры начинаются с инвентаризации приложений, баз, доменов, сертификатов, очередей и окружений. Проектируем CI/CD под фактический стек, включая проверки, миграции, публикацию и откат. Мониторинг связываем с пользовательскими сценариями, резервные копии проверяем восстановлением. Документация описывает выпуск, rollback, ротацию секретов и действия при инциденте.
Собираем компоненты, окружения, данные, интеграции, владельцев, доступы, зависимости и операции, которые остаются у внешнего провайдера.
Разделяем development, staging и production, фиксируем источник версии, переменные, допустимые данные, домены и сетевые границы.
Применяем сервисные учётные данные, минимальные права, защищённое хранение, порядок выдачи, ротации и отзыва доступа.
Воспроизводим зависимости, сборку, статические проверки и тесты, сохраняя понятную причину остановки процесса.
Контролируем окружение, параллельность, версию, миграции, approval, health check, журнал и возврат к безопасному состоянию.
Связываем телеметрию с сервисом, окружением, версией и запросом, ограничиваем чувствительные данные и избыточную кардинальность.
Настраиваем сигналы по пользовательским симптомам и критичным фоновым процессам, назначаем владельца, канал и runbook.
Определяем состав, расписание, хранение, защиту и контроль копий, затем восстанавливаем согласованный набор данных в отдельном контуре.
Результат этапа
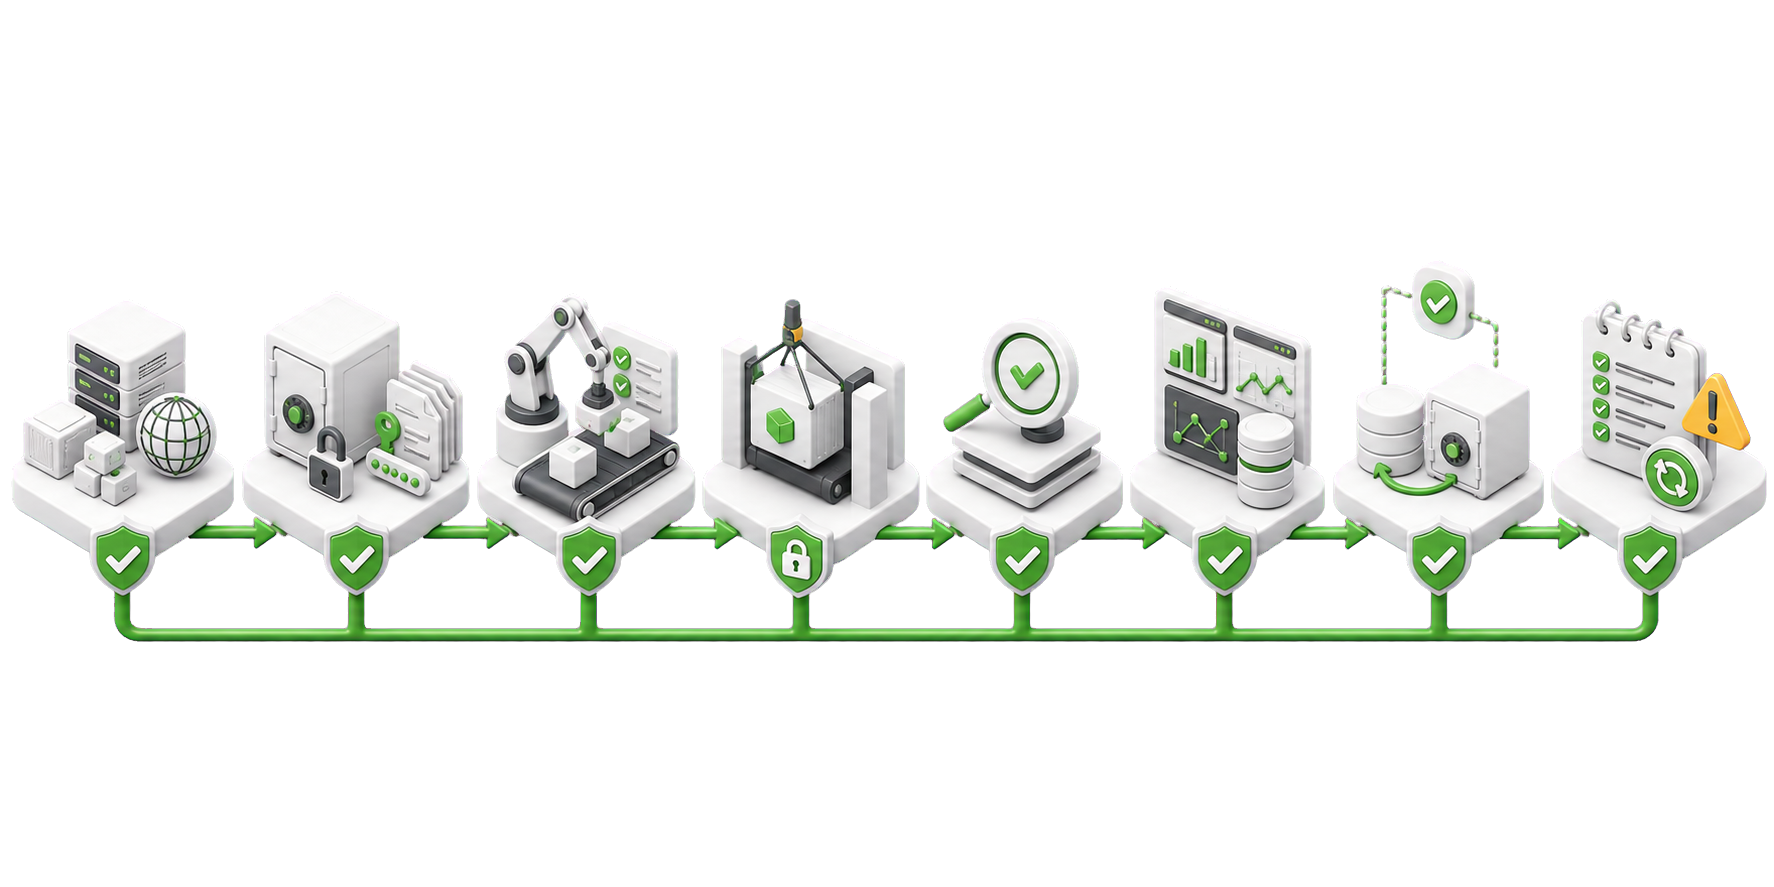
Зафиксированы приложения, данные, интеграции, домены, процессы, владельцы, границы провайдеров и критичные единичные точки.
Репозиторий, проверки, окружения, секреты, approval, журнал, миграции, health check и rollback связаны в воспроизводимый процесс.
Доступны согласованные логи, метрики, трассировки, dashboards и сигналы с владельцем и понятным действием.

Документированы выпуск, откат, ротация, инциденты и восстановление, сохранён результат практической проверки резервной копии.
Выбор формата
| Формат | Когда подходит | Что получает заказчик |
|---|---|---|
| Разовая инфраструктурная задача | Нужно перенести приложение, настроить окружение, сертификат, backup или отдельный pipeline. | Ограниченное изменение, проверка результата, документация и передача доступов. |
| DevOps и инфраструктура | Нужно связать разработку, выпуск, наблюдаемость, восстановление и ответственность в устойчивый процесс. | Эксплуатационный контур, автоматизация, сигналы, backup, runbook и правила изменения. |
| Техническая поддержка | Процесс уже работает и требуется регулярно принимать обращения, выполнять профилактику и устранять инциденты. | Согласованный режим сопровождения, классификация задач, плановые работы и отчётность. |
Экспертная методика
Сначала фиксируем текущую архитектуру, процесс релиза и критичные риски. Затем внедряем изменения небольшими проверяемыми этапами: репозиторий конфигураций, автоматические проверки, развёртывание, наблюдаемость и восстановление. Каждый этап имеет сценарий проверки и возврата.
Инвентаризируем окружения, зависимости, доступы, релизный процесс и точки отказа.
Настраиваем сборку, проверки, развёртывание и управляемые конфигурации.
Подключаем метрики, журналы, оповещения, резервирование и проверку восстановления.
Пример эксплуатационного требования
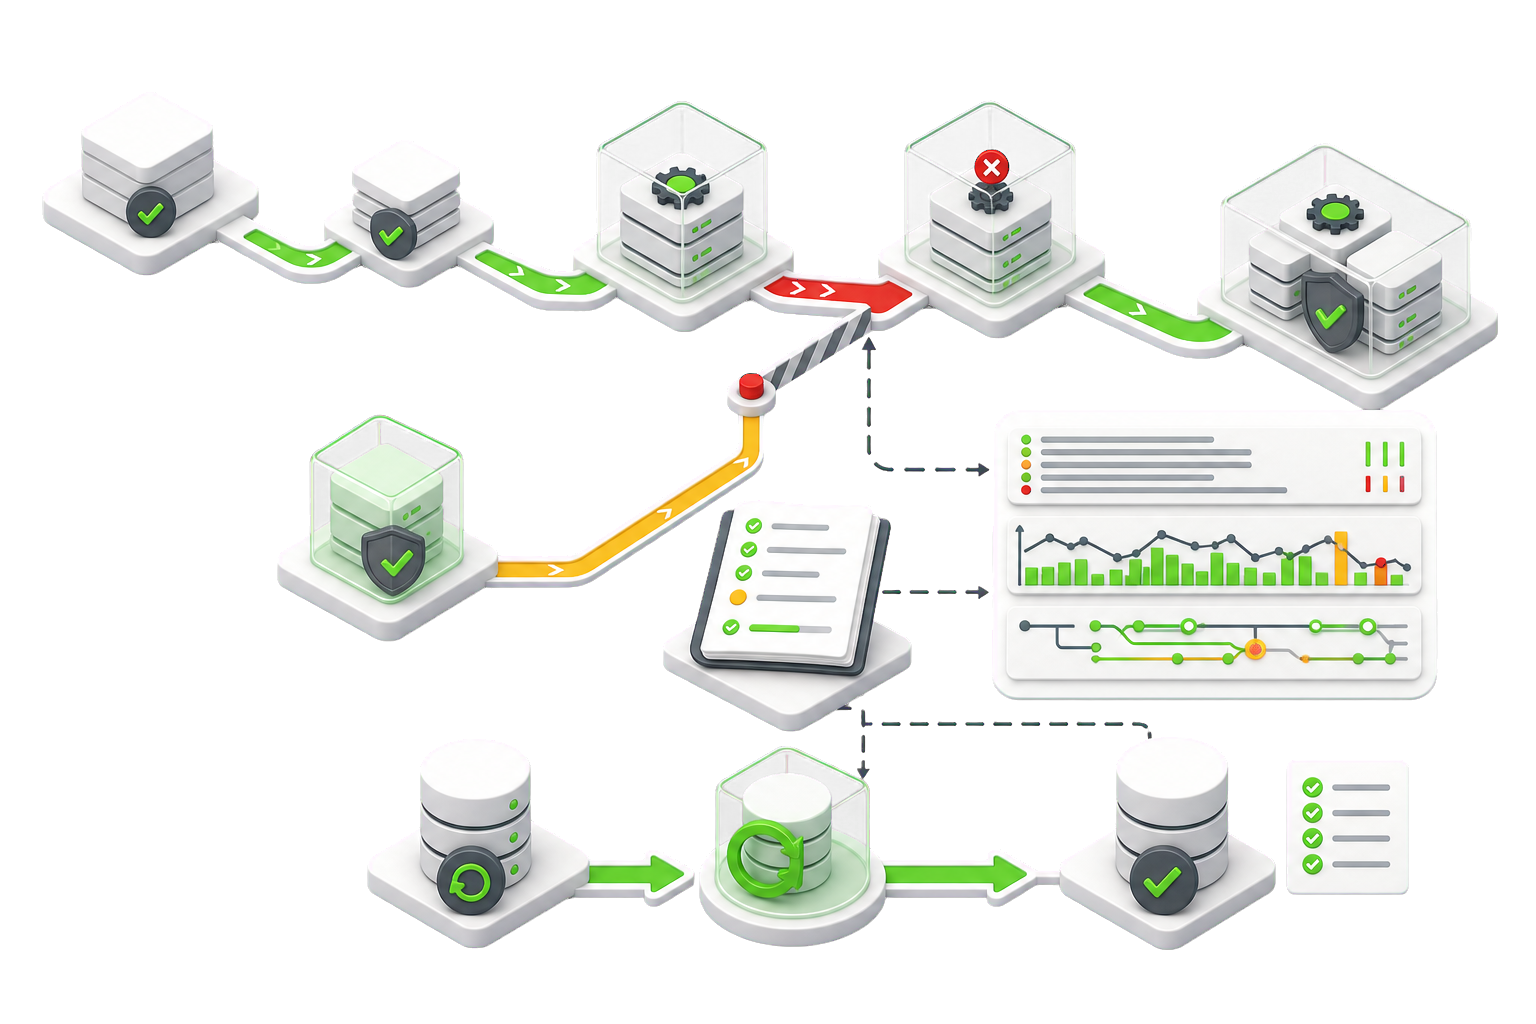
Пример показывает структуру требования без привязки к конкретному провайдеру, клиенту или обещанию доступности. Он связывает изменение, проверку, остановку и восстановление.
Коммерческие условия
Стоимость зависит от числа окружений и сервисов, облака или серверов, требований к доступности, безопасности и скорости релизов. Работу можно начать с аудита и плана приоритетных изменений.
Пример решения
Этапы реализации
Фиксируем приложения, окружения, данные, зависимости, домены, процессы, доступы, текущий выпуск, backup и критичные сценарии.
Определяем допустимые действия, простой, потерю данных, режим выпуска, владельцев, каналы уведомлений и критерии результата.
Выбираем окружения, pipeline, управление конфигурацией, сигналы, backup, rollback и документацию без лишней инфраструктуры.
Настраиваем репозиторий, проверки, доступы, секреты, выпуск, health checks, телеметрию, оповещения и резервные процедуры.
Тестируем остановку выпуска, rollback, потерю зависимости, путь уведомления, восстановление данных и запуск приложения.
Объясняем архитектуру, стандартные операции, ограничения, первые действия при инциденте и порядок дальнейшего сопровождения.
Управление эксплуатационным риском
Шаги, входы, проверки, версия, журнал и rollback фиксируются в воспроизводимом процессе и runbook.
Используем защищённое хранение, минимальные права, маскирование, сервисные учётные данные и управляемую ротацию.
Срочные сигналы связываются с пользовательским влиянием и действием, диагностические причины остаются в dashboards и задачах.
Проверяем состав и доступность копии, выполняем восстановление в отдельном контуре и документируем обнаруженные зависимости.
Опыт, экспертиза и доверие
Методика S.O.L CORP основана на анализе задачи, проверке исходных данных и применении профильной документации. Для каждой услуги мы определяем состав работ, ограничения, критерии результата и порядок проверки. Решения адаптируются под конкретный проект и согласуются с заказчиком до начала реализации.
Связанные услуги для веб-проекта
Вопросы и ответы
Состав может включать инвентаризацию, окружения, конфигурацию, доступы и секреты, автоматические проверки, CI/CD, выпуск, миграции, health checks, rollback, логи, метрики, трассировки, оповещения, backup, восстановление и runbook. Глубина определяется архитектурой и риском проекта.
Нет. Инструмент выбирается только при подтверждённой пользе для воспроизводимости, изоляции, масштабирования или эксплуатации. Небольшой сайт, стандартный WordPress или штатная архитектура Layer могут надёжно работать без дополнительного оркестратора и внешнего reverse proxy.
Да. Сначала фиксируются текущая сборка, окружения, секреты, миграции, ручные шаги и риск отката. Затем автоматизируется минимально достаточный путь с журналом версии, проверками, ограничением доступа и безопасной остановкой.
Мониторинг отвечает на заранее заданные вопросы через известные показатели и проверки. Наблюдаемость помогает исследовать новое поведение через связанные логи, метрики и трассировки. Для практического результата сигналы привязываются к версии, окружению и пользовательскому сценарию.
Сам факт создания архива не гарантирует пригодность. Нужно определить состав данных, защиту, хранение и контроль выполнения, а затем восстановить копию в отдельном контуре и проверить согласованное состояние зависимого приложения.
Да. В зависимости от проекта настраиваются репозиторий темы и собственного кода, безопасные обновления, staging, конфигурация, база, загрузки, cron, кеш, резервные копии, выпуск и проверки. Плагины и контент учитываются отдельно от кода.
Да. Для стандартного Layer-проекта сохраняется штатная топология: движок работает на настроенных HTTP/HTTPS-портах, а PM2 cluster управляет процессами. Nginx, Docker, Kubernetes и внешний reverse proxy не добавляются без отдельной технической причины.
От числа приложений, окружений, репозиториев, баз, интеграций, провайдеров, миграций, требований к выпуску, наблюдаемости и восстановлению. После инвентаризации определяется минимальный этап. SLA, RPO, RTO и режим поддержки согласуются отдельно.
Начнём с задачи
Опишите приложение, технологии, окружения, текущий путь выпуска, наблюдаемые проблемы, требования к backup и доступные материалы. Мы определим границы инвентаризации, минимальный эксплуатационный контур и критерии проверяемого результата.